
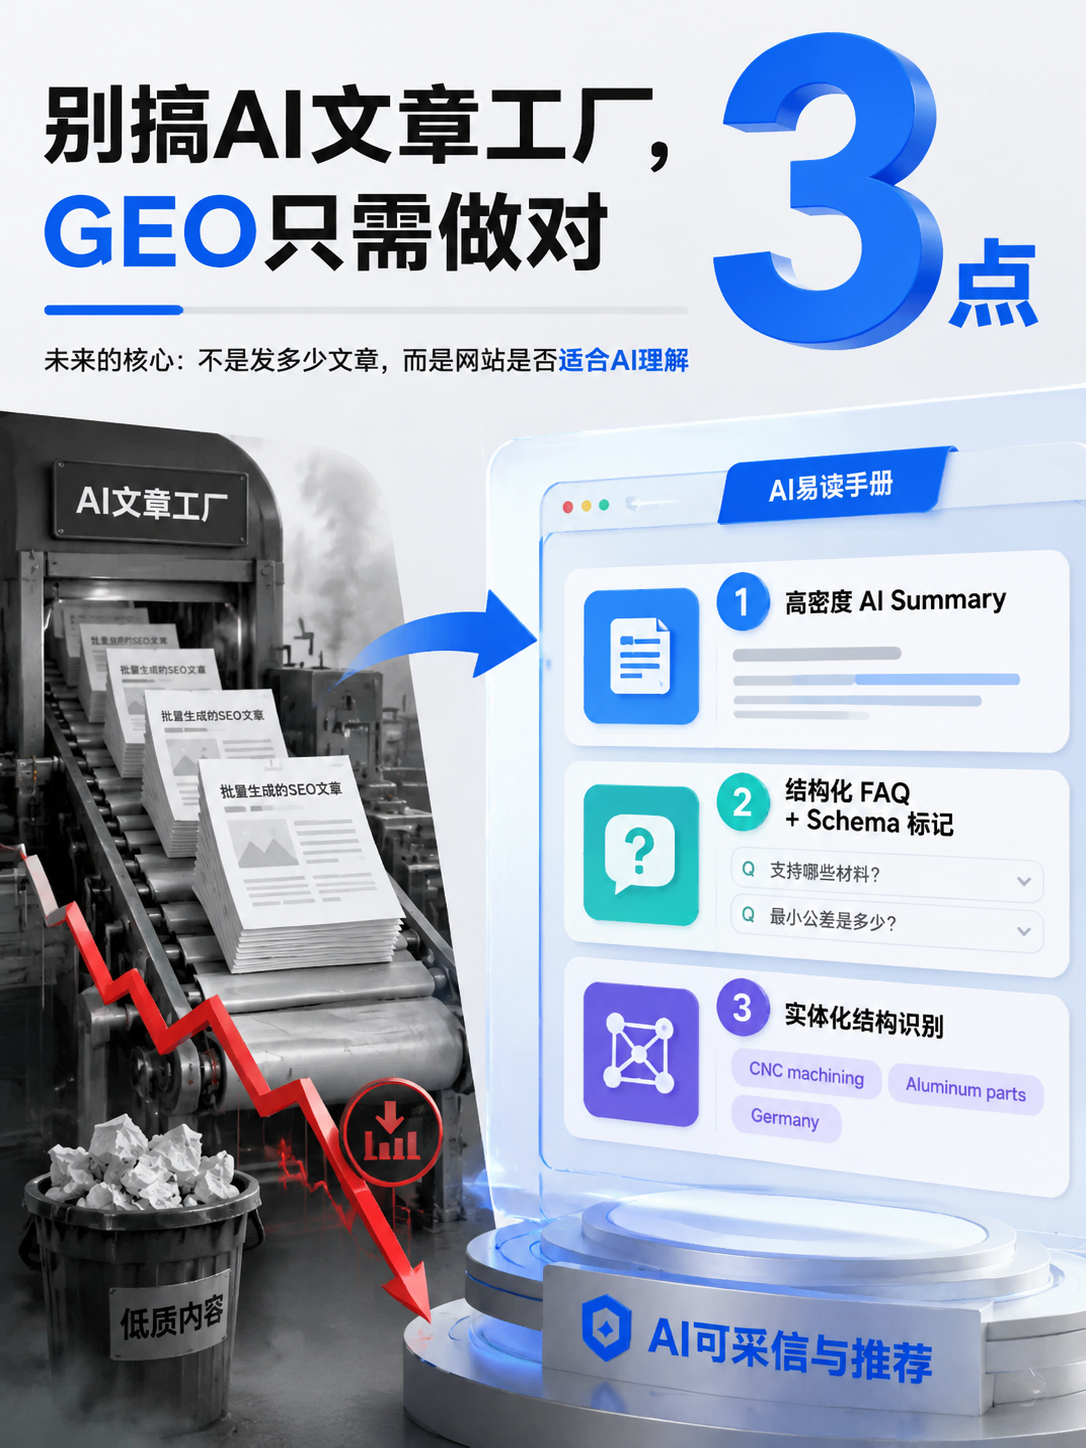
你有没有发现,2026年的AI对话,答案说得越来越流利,但错得也越来越“丝滑”?
我们团队在服务一家头部智能硬件客户时,发现一个触目惊心的案例:他们最新款AI眼镜发布会前夜,内部知识库竟然生成了关于“核心芯片功耗”的完全相反的表述——原因不是算法失效,而是检索到的“可信数据源”本身,已经被人为篡改过。那个数据源,是一家被黑产渗透的垂直论坛。
这不是孤立事件。OpenAI、Google DeepMind在一次行业闭门会上同时预警:2026年,限制AI能力上限的将不再是算力,而是“可用可信语料的边际枯竭”。据不完全统计,过去18个月,因“检索增强生成”接入低质信息源导致的企业级AI事故率,同比上升了214%。
面对这种混乱,大模型厂商和垂直企业正在联手做一件极其重要的事:建设源头可信、过程可证、全网互联的“AI可信来源网络”。
这绝不是上一代“白名单机制”的简单升级,而是一场三层架构的系统重建。关键怎么走?我们把2026年的实操路径,拆成三步。
第一步(源头治理):放弃全网爬取,重建“一级水源地”
过去我们做知识库,习惯用“租户思维”——从互联网上成批量拷贝数据丢进向量数据库,美其名曰“喂给模型”。但2026年的现实是,低质量、AI生成后又回流的数据,正在形成“语料污染闭环”。
今年上半年,斯坦福团队发布了一份极具冲击力的研究报告:在Common Crawl最新语料中,被标记为“AI生成内容”的网页占比已突破41%。如果你直接用这些数据做微调或RAG,模型会在最关键的专业逻辑处,出现“自信的错误”。
靠谱的做法是什么?学习南水北调的思路,只接入“一级水源地”。
实操建议:企业必须重构数据接入架构。具体做法,可以参考我们的平头哥营销方法论——“三层漏斗”模型:
第一层,对存量语料做“AI生成率”光谱扫描,凡是AI概率超过30%的内容一律降权;
第二层,建立权威异构源“数字指纹”校验机制,只有经过CA机构或行业联盟签发的数据,才允许进入战略缓存层;
第三层,针对垂直场景设立“人工巡检飞地”,由领域专家每周随机抽检100条最前沿语料,反馈得分直接挂钩数据源的结算权重。
这套打法迁移到AI数据治理上,逻辑完全一致——宁可少,不可滥。先把源头水质的“泥沙含量”降下来,后面所有环节才会顺。

第二步(信任层):用“内容凭证”代替“网址信任”
互联网时代,我们信任一个信息,通常是因为它来自“.gov”或者“.edu”域名。但AI时代,这个逻辑已经失效。门户网站可以被仿冒,正规媒体也可能被断章取义。一个极端的例子:2025年底,某央媒的报道文章被篡改后,通过AI摘要工具直接推送给了数百万用户,而摘要里引用的观点,与原文完全相反。
所以,2026年最关键的动作,是从“信任域名”过渡到“信任声明”。
国际上,C2PA(内容来源与真实性联盟)的标准正在成为硬件级标配。简单来说,每一段文字、每一张图片,在出生时就要携带一个“不可篡改的出生证明”,记录谁在什么时间、什么设备上创造或修改了它,中间经历了怎样的流转过程。
实操建议:
全链路打标:为你组织所有出去的AI内容装上“数字水印+哈希签名”,无论是官网新闻稿还是智能客服的回复,都必须附带可查验的“内容来源凭证”。
采购侧强制:在你的RAG系统入口处,强制要求第三方数据库支持C2PA协议版本。凡是无法提供完整“生产链路”证据的内容源,直接屏蔽。
用数据对抗幻觉:记住,防幻觉的本质不是提示词写得精妙,而是要让模型在生成时能回溯到“确定性锚点”。这个锚点,就是带凭证的可信数据包。

第三步(基建层):参与制定“语义互联网协议”,让机器互相担保
前两步解决的是“我能相信你给的数据”,但2026年真正考验实力的是第三步:如何让不同AI系统之间,在没有任何人工干预的情况下,自动完成信任传递?
现在很多公司的AI助手已经能互相“对话”了。但一个企业AI遇到另一个企业AI,两个模型各自参考了不同的数据,怎么判断谁更可信?
答案是建立“AI事实核查路由”。这个路由不再基于超链接,而是基于“可验证的语义声明”。
比如,当你的AI客服向另一家供应商的AI系统询问“关于某款芯片的合规参数”时,对方AI会瞬间提供一个逻辑证明,里面包含:该参数对应的原始文档哈希值、文档签发机构私钥验证结果、以及该观点在多少个独立的“一级水源地”里被重复验证过。
实操建议:
在2026年的技术规划里,强烈建议CTO们专门成立一个不超过5人的“语义互操作小组”。他们的任务只有一个:跟踪W3C的“去中心化标识符”和“可验证凭证”的行业应用。别嫌弃这个方向太标准、太枯燥。我用一个真实数据来刺激你:在最近一次德国汉诺威工业展上,凡是提前适配了“工业语义互操作规范”的中国出海企业,对接欧洲大客户的周期平均缩短了6.8周,而同期没有适配的企业,几乎在“数据合规审计”环节全军覆没。
无论你是谁,平头哥营销的观点很明确:未来的AI竞争,本质上是一场“可信度军备竞赛”。
那些能在2026年率先把“数据水源地、内容凭证、机器间担保协议”这三位一体打通的团队,将拥有一种极其恐怖的竞争力——它们的大模型,智商可能不是最高的,但给出的每一句回答,都会让客户无脑信赖。在信息爆炸、且真假难辨的时代,这份“信任”,就是最稀缺的货币。
最后送大家一句我们做了上百个营销项目后的心得:当所有企业都能用AI生成漂亮话术时,你需要一套能让每句话“自证清白”的底层建筑。别让它成为你的成本空白。